Modellübersicht
Was ist F5 TTS? Ein klarer Leitfaden zum Sprachmodell
Was ist F5 TTS? Es ist ein Text-to-Speech-Modell, das eine kurze Referenzaufnahme und geschriebenen Text verwendet, um Sprache mit einer ähnlichen stimmlichen Prägung, einem ähnlichen Rhythmus und einer vergleichbaren ausdrucksstarken Sprechweise zu erzeugen. Dieser Leitfaden erklärt das Modell auf praktische Weise.
Kernablauf
So funktioniert F5 TTS
F5 TTS kombiniert eine Referenzstimme mit dem Zieltext und erzeugt anschließend Sprache, die den akustischen Merkmalen der Referenz folgt und dabei die gewünschten Wörter beibehält.
-
1
Referenzaudio bereitstellen
Wähle eine klare Sprachprobe mit ausreichend gesprochenem Inhalt, damit das Modell Ton, Sprechtempo, Aussprache und andere akustische Eigenschaften erkennen kann.
-
2
Zieltext hinzufügen
Gib die Wörter ein, die gesprochen werden sollen. Der Text liefert die Botschaft, während die Referenzaufnahme das stimmliche Beispiel liefert, das die Ausgabe steuert.
-
3
Sprache erzeugen
F5 TTS stimmt Referenz und Text aufeinander ab und synthetisiert anschließend ein Audioergebnis, das zusammenhängend, natürlich und mit der bereitgestellten Stimme verwandt klingen soll.
Verwandte Themen
Was F5 TTS leisten kann
Diese verwandten Seiten betrachten das Modell aus praktischer Perspektive, einschließlich seines Stimmverhaltens, des Online-Zugriffs und des Klon-Workflows.
- Was ist die F5-TTS-Stimme? Erfahre, wie die Referenzstimme des Modells den Ton, das Sprechtempo und den Charakter der erzeugten Sprache prägt.
- F5 TTS online Erfahre, was eine Online-Oberfläche im Vergleich zur Ausführung des Modells in einer lokalen Einrichtung verändert.
- F5-TTS-Stimmenklonen Verstehe, wie referenzbasierte Synthese mit Stimmenklonen zusammenhängt und wo eine sorgfältige Nutzung wichtig ist.
Von der Eingabe zur Ausgabe
F5 TTS in der Praxis
Die zentrale Transformation ist einfach: Eine Sprachreferenz und ein geschriebenes Skript werden zu einer neuen gesprochenen Passage. Die Qualität hängt von der Aufnahme, dem Text und den Einstellungen für die Generierung ab.
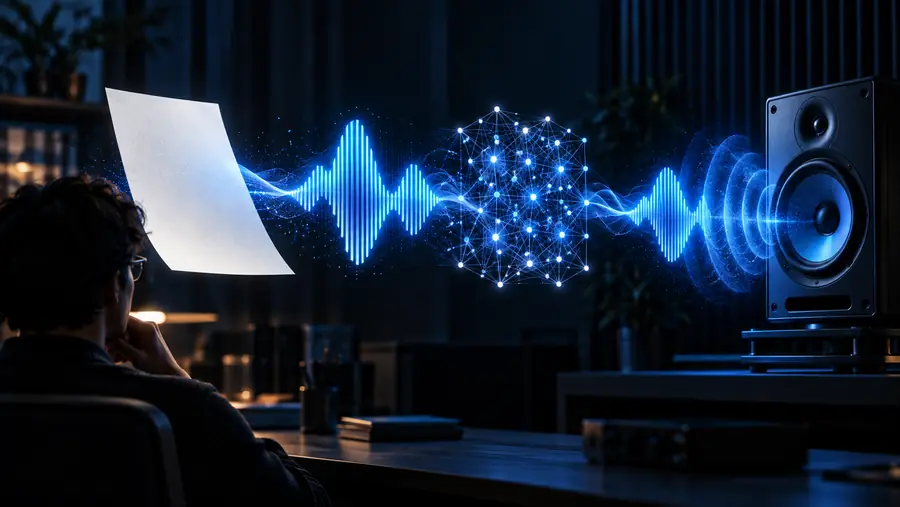
Die Ausgabe orientiert sich an der Referenz und ist keine perfekte Aufnahme davon.
Referenz und SkriptGenerierte SpracheEin praktischer Vergleich
Wer F5 TTS verwendet
F5 TTS lässt sich am besten als ein referenzgesteuertes Sprachmodell verstehen und nicht als universeller Ersatz für jeden Sprach-Workflow.
| F5-TTS-Workflow | Herkömmliches TTS mit fester Stimme | |
|---|---|---|
| Spracheingabe | Verwendet eine kurze Referenzaufnahme, um die generierte Stimme zu steuern | Wählt normalerweise aus einer vordefinierten Stimmenbibliothek aus |
| Textsteuerung | Generiert Sprache aus dem bereitgestellten Skript | Generiert Sprache aus dem bereitgestellten Skript |
| Stimmenvielfalt | Kann die Ausgabe an verschiedene Referenzstimmen anpassen | Die Vielfalt hängt von den Stimmen ab, die der Anbieter bereitstellt |
| Ausdruckselemente | Kann Aspekte des Tempos und der Vortragsweise der Referenz widerspiegeln | Folgt häufig den stilistischen Grenzen einer festen Stimme |
| Konsistenz | Kann je nach Qualität der Referenz, Text und Einstellungen variieren | Oft vorhersehbarer innerhalb einer voreingestellten Stimme |
| Typische Nutzer | Kreative, Forschende, Entwickler und Teams, die Sprach-Workflows testen | Alle, die unkomplizierte Sprache aus einer stabilen Voreinstellung benötigen |
| Am besten geeignet für | Referenzbasierte Experimente und ausdrucksstarke Erzählungen | Routine-Erzählungen mit einer bekannten, wiederholbaren Stimme |
Wichtige Hinweise
Wo F5 TTS an Grenzen stößt
Auch ein leistungsfähiges Modell benötigt geeignete Eingaben und einen verantwortungsvollen Umgang. Diese Grenzen helfen dabei, vor der Sprachgenerierung realistische Erwartungen zu setzen.
Es kann keine exakte stimmliche Kopie garantieren
Eine Referenzaufnahme beeinflusst das Ergebnis, aber die generierte Sprache kann sich in Klangfarbe, Aussprache, Emotion oder Timing unterscheiden.
Was stattdessen zu tun ist
Verwenden Sie eine klare, passende Referenz und vergleichen Sie mehrere Ergebnisse, anstatt eine perfekte Kopie zu erwarten.
Es kann nicht jede mangelhafte Aufnahme korrigieren
Hintergrundgeräusche, Überschneidungen, Clipping, sehr kurze Samples oder undeutliche Sprache können das Referenzsignal schwächen.
Was stattdessen zu tun ist
Beginnen Sie mit einer klaren Aufnahme, die eine einzelne sprechende Person und möglichst wenige Umgebungsgeräusche enthält.
Es kann die redaktionelle Prüfung nicht ersetzen
Das Ergebnis kann Namen, Abkürzungen, ungewöhnliche Wörter oder Texte mit mehrdeutiger Zeichensetzung falsch aussprechen.
Was stattdessen zu tun ist
Hören Sie sich das vollständige Ergebnis an und überarbeiten Sie das Skript oder ausspracheempfindliche Abschnitte.
Es kann keine Zustimmung zur Nutzung einer Stimme nachweisen
Die technische Möglichkeit beweist nicht, dass eine Person der Nutzung ihrer aufgenommenen Stimme zugestimmt hat.
Was stattdessen zu tun ist
Verwende Stimmen mit entsprechender Genehmigung und kennzeichne synthetische oder referenzgesteuerte Audiodateien, wenn dies erforderlich ist.
Nächster Schritt
Ordne das Modell in den Kontext ein
F5 TTS lässt sich am einfachsten verstehen, wenn man seine Eingaben, seinen Workflow und die erzeugten Ergebnisse miteinander vergleicht. Erkunde die Anwendung über den verfügbaren Produktpfad und beurteile anschließend, ob der referenzbasierte Ansatz zu deinem Erzähl- oder Sprachprojekt passt.
Höre, wie referenzgesteuerte Sprache klingen kann
- Beginne mit einer klaren Referenzaufnahme
- Verwende ein kurzes Skript mit eindeutiger Zeichensetzung
- Überprüfe jedes erzeugte Ergebnis vor der Veröffentlichung
Häufige Frage
F5 TTS – FAQ
F5 TTS ist ein Text-to-Speech-Modell, das aus geschriebenem Text gesprochene Audiodateien erzeugt und dabei eine Referenzaufnahme zur Steuerung der Stimme verwendet. Es wurde für die referenzbasierte Sprachsynthese entwickelt, anstatt nur aus einer festen Liste voreingestellter Stimmen auszuwählen.
Es ist sowohl ein trainiertes Sprachmodell als auch Teil eines Text-to-Speech-Workflows. Das Modell verarbeitet Text zusammen mit Referenzaudio, um eine neue gesprochene Passage mit ähnlichen akustischen Eigenschaften zu erzeugen.
Nein. F5 TTS kann eine Referenzaufnahme verwenden, um Stimmcharakter, Sprechtempo und Vortrag zu steuern. Die Ergebnisse hängen jedoch von der Aufnahme, dem Skript und den Bedingungen der Generierung ab. Die Ähnlichkeit sollte als Ziel für die Ausgabequalität verstanden werden, nicht als Garantie.
Der grundlegende Workflow benötigt den Zieltext und eine geeignete Referenzaufnahme. Klare Aufnahmen mit nur einer sprechenden Person liefern dem Modell in der Regel mehr verwertbare Informationen als verrauschtes, übersteuertes, überlappendes oder sehr kurzes Material.
F5 TTS kann für Entwickler, Kreative, Forschende und Teams nützlich sein, die ausdrucksstarke oder referenzgesteuerte Narration erkunden. Es eignet sich besonders, wenn die Anpassung an eine Sprachreferenz wichtiger ist als die Verwendung einer standardmäßigen voreingestellten Stimme.