モデルの概要
F5 TTSとは?音声生成モデルをわかりやすく解説
F5 TTSとは?短い参照音声と入力テキストを使い、声質やリズム、表現が参照音声に似た音声を生成するテキスト読み上げモデルです。このガイドでは、モデルの仕組みを実用的な観点から説明します。
基本的な流れ
F5 TTSの仕組み
F5 TTSは参照音声と読み上げたいテキストを組み合わせ、指定された言葉を正確に保ちながら、参照音声の音響的な特徴に沿った音声を生成します。
-
1
参照音声を用意する
モデルが声の調子、話す速さ、発音などの音響的な特徴を捉えられるよう、十分な発話を含む明瞭な音声サンプルを選びます。
-
2
読み上げたいテキストを入力する
話させたい言葉を入力します。テキストが伝える内容を指定し、参照音声が出力を導く声の見本になります。
-
3
音声を生成する
F5 TTSは参照音声とテキストを対応付け、自然で一貫性があり、提供された声に近い音声を合成します。
関連ページ
F5 TTSでできること
関連ページでは、声の特徴、オンラインでの利用、音声クローンの手順など、実用的な観点からモデルを紹介します。
入力から出力まで
F5 TTSの実用例
中心となる変換はシンプルです。音声リファレンスと記述された台本から、新しい音声による発話が生成されます。品質は、録音、テキスト、生成設定に左右されます。
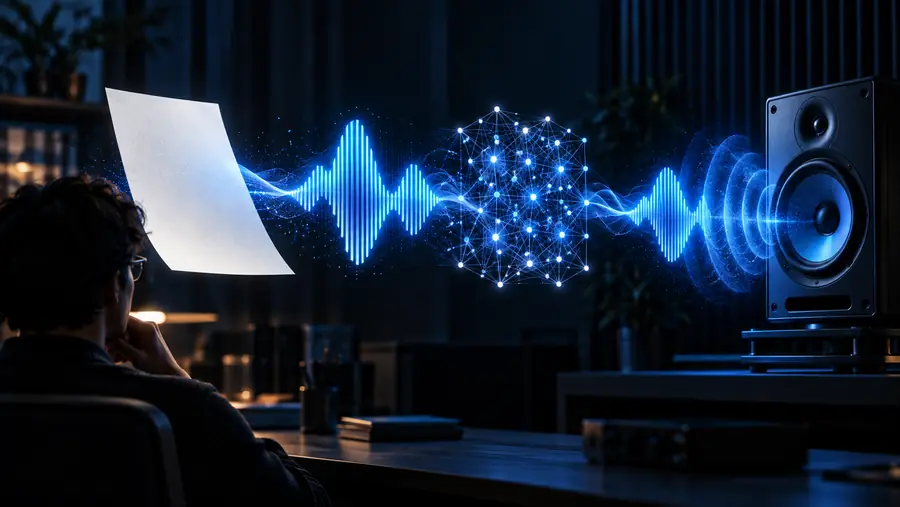
出力はリファレンスに従うものであり、それを完全に録音したものではありません。
リファレンスと台本生成された音声実用的な比較
F5 TTSを使う人
F5 TTSは、あらゆる音声ワークフローに対応する万能な代替手段というよりも、リファレンスに基づいて音声を生成するモデルとして理解するのが適切です。
| F5 TTSのワークフロー | 従来の固定音声TTS | |
|---|---|---|
| 音声入力 | 短いリファレンス録音を使用して、生成される音声をガイドします | 通常は、あらかじめ用意された音声ライブラリから選択します |
| テキスト制御 | 入力された台本から音声を生成します | 入力された台本から音声を生成します |
| 音声の多様性 | 異なるリファレンス音声に合わせて出力を調整できます | 多様性は、プロバイダーが収録している音声によって決まります |
| 表現上の手がかり | リファレンスのタイミングや話し方の一部を反映できます | 多くの場合、固定音声のスタイル上の制限に従います |
| 一貫性 | リファレンスの品質、テキスト、設定によって変動する場合があります | 1つのプリセット音声内では、より予測しやすいことが多い |
| 主な利用者 | 音声ワークフローを試すクリエイター、研究者、開発者、チーム | 安定したプリセット音声で手軽に音声を生成したい人 |
| 最適な用途 | 参照音声を使った実験や表現豊かなナレーション | 既知の音声で繰り返し作成する日常的なナレーション |
重要な注意点
F5 TTSの限界
高性能なモデルでも、適切な入力と責任ある取り扱いが必要です。音声を生成する前に、これらの制約を踏まえて現実的な期待値を設定しましょう。
声を完全に再現できるとは限りません
参照音声は生成結果の指針になりますが、生成された音声は声質、発音、感情表現、タイミングが異なる場合があります。
代わりにできること
完全な複製を期待するのではなく、明瞭で用途に合った参照音声を使い、複数の生成結果を比較してください。
質の悪い録音を必ず補正できるわけではありません
背景雑音、声の重なり、音割れ、極端に短いサンプル、不明瞭な発話は、参照音声としての有効性を弱める可能性があります。
代わりにできること
話者が1人で、周囲の雑音が少ない明瞭な録音を使用してください。
内容の確認に代わるものではありません
名前、略語、珍しい単語、句読点の解釈が曖昧な文章は、正しく発音されない場合があります。
代わりにできること
生成結果を最後まで聞き、原稿や発音に注意が必要な箇所を修正してください。
声の使用許可を得ることはできません
技術的に可能であっても、録音された声の使用について本人が同意した証拠にはなりません。
代わりにできること
適切な許可を得た音声を使用し、必要に応じて合成音声または参照音声に基づく音声であることを明示してください。
次のステップ
モデルを文脈に置く
F5 TTSは、入力、ワークフロー、生成結果を比較すると理解しやすくなります。利用可能な製品ページで実際の体験を確認し、参照音声に基づくアプローチがナレーションや音声プロジェクトに適しているか判断してください。
よくある質問
F5 TTS FAQ
F5 TTSは、参照録音を使って音声を導きながら、書かれたテキストから話し言葉の音声を生成するテキスト読み上げモデルです。固定されたプリセット音声のリストから選ぶのではなく、参照音声に基づく音声合成を目的として設計されています。
訓練済みの音声モデルであると同時に、テキスト読み上げワークフローの一部でもあります。モデルはテキストと参照音声を組み合わせて処理し、関連する音響特性を持つ新しい発話を生成します。
いいえ。F5 TTSは参照録音を使って声の特徴、ペース、話し方を導くことができますが、結果は録音、台本、生成条件によって異なります。類似性は出力品質の目標として捉えるべきであり、保証されるものではありません。
基本的なワークフローには、生成対象のテキストと適切な参照録音が必要です。明瞭な単一話者の音声は、ノイズ、音割れ、話者の重なり、または極端に短い素材よりも、通常、モデルに有用な情報を多く提供します。
F5 TTSは、表現力豊かなナレーションや参照音声に基づくナレーションを探求する開発者、クリエイター、研究者、チームに役立ちます。標準的なプリセット音声を使うよりも、音声参照を適応させることが重要な場合に最も適しています。