Présentation du modèle
Qu’est-ce que f5 tts ? Un guide clair du modèle de synthèse vocale
Qu’est-ce que f5 tts ? Il s’agit d’un modèle de synthèse vocale qui utilise un court enregistrement de référence et du texte écrit pour produire une voix présentant des caractéristiques vocales, un rythme et une expressivité similaires. Ce guide explique le modèle en termes pratiques.
Fonctionnement principal
Comment fonctionne f5 tts
f5 tts combine une voix de référence avec le texte cible, puis génère une voix qui suit les caractéristiques acoustiques de la référence tout en préservant les mots demandés.
-
1
Fournir un fichier audio de référence
Choisissez un échantillon vocal clair contenant suffisamment de paroles pour permettre au modèle d’identifier le ton, le rythme, la prononciation et d’autres caractéristiques acoustiques.
-
2
Ajouter le texte cible
Saisissez les mots que vous souhaitez faire prononcer. Le texte fournit le message, tandis que l’enregistrement de référence fournit l’exemple vocal qui guide le résultat.
-
3
Générer la voix
f5 tts aligne la référence et le texte, puis synthétise un résultat audio conçu pour être cohérent, naturel et lié à la voix fournie.
Pages associées
Ce que f5 tts peut faire
Ces pages associées examinent le modèle sous des angles pratiques, notamment son comportement vocal, son accès en ligne et son processus de clonage.
- voix f5 tts : de quoi s’agit-il ? Découvrez comment la voix de référence du modèle façonne le ton, le rythme et le caractère de la voix générée.
- f5-tts en ligne Découvrez ce qu’une interface en ligne change par rapport à l’exécution du modèle dans une configuration locale.
- clonage de voix avec f5 tts Comprenez comment la synthèse basée sur une référence s’inscrit dans le clonage vocal et pourquoi une utilisation prudente est importante.
De l’entrée à la sortie
f5 tts en pratique
La transformation est simple : un enregistrement vocal de référence et un texte deviennent un nouveau passage parlé. La qualité dépend de l’enregistrement, du texte et des paramètres de génération.
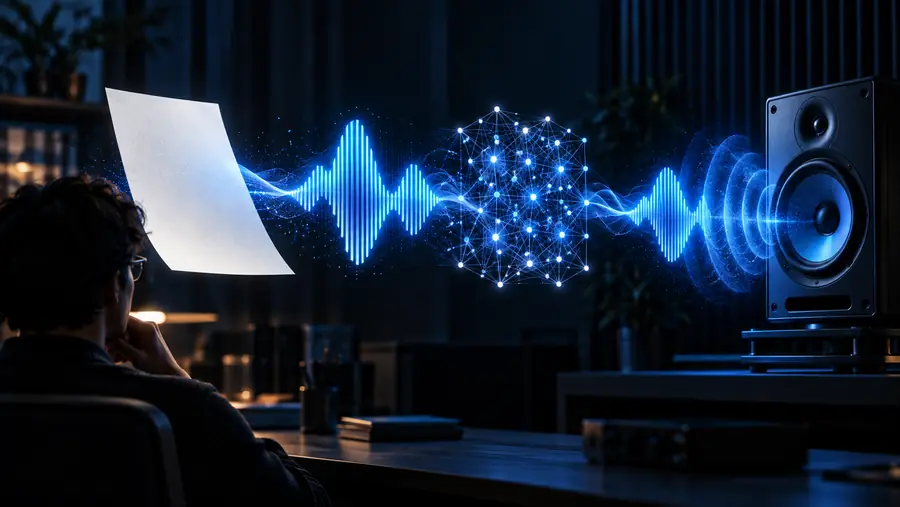
Le résultat s’inspire de la référence, sans en être une reproduction parfaite.
Référence et texteParole généréeUne comparaison pratique
Qui utilise F5 TTS
F5 TTS est avant tout un modèle de synthèse vocale guidé par une référence, plutôt qu’un outil capable de remplacer toutes les méthodes de production vocale.
| Fonctionnement de F5 TTS | Synthèse vocale classique à voix prédéfinies | |
|---|---|---|
| Entrée vocale | Utilise un court enregistrement de référence pour guider la voix générée | Choisit généralement une voix dans une bibliothèque prédéfinie |
| Contrôle du texte | Génère de la parole à partir du texte fourni | Génère de la parole à partir du texte fourni |
| Variété des voix | Peut adapter le résultat à différentes voix de référence | La variété dépend des voix proposées par le fournisseur |
| Nuances expressives | Peut refléter certains aspects du rythme et de l’interprétation de la référence | Respecte souvent les limites stylistiques d’une voix prédéfinie |
| Cohérence | Peut varier selon la qualité de la référence, le texte et les paramètres | Souvent plus prévisible avec une voix prédéfinie |
| Utilisateurs types | Créateurs, chercheurs, développeurs et équipes testant des flux de travail vocaux | Toute personne ayant besoin d’une parole simple avec une voix prédéfinie stable |
| Le mieux adapté pour | Expérimentations basées sur une référence et narration expressive | Narration courante avec une voix connue et reproductible |
Points importants à connaître
Les limites de f5 tts
Même un modèle performant a besoin d’entrées adaptées et d’une utilisation responsable. Ces limites permettent de définir des attentes réalistes avant de générer la parole.
Il ne peut pas garantir une copie vocale exacte
Un enregistrement de référence guide le résultat, mais la parole générée peut différer par le timbre, la prononciation, l’émotion ou le rythme.
Que faire à la place
Utilisez une référence claire et pertinente, puis comparez plusieurs résultats au lieu d’attendre un double parfait.
Il ne peut pas corriger tous les mauvais enregistrements
Le bruit de fond, les chevauchements de voix, l’écrêtage, les échantillons très courts ou une parole peu claire peuvent affaiblir le signal de référence.
Que faire à la place
Commencez par un enregistrement clair contenant une seule voix et un minimum de bruit ambiant.
Il ne peut pas remplacer la vérification éditoriale
Le résultat peut mal prononcer les noms, les abréviations, les mots inhabituels ou les textes dont la ponctuation est ambiguë.
Que faire à la place
Écoutez l’intégralité du résultat et révisez le script ou les passages sensibles à la prononciation.
Il ne peut pas établir l’autorisation d’utiliser une voix
La capacité technique ne prouve pas qu’une personne a accepté l’utilisation de sa voix enregistrée.
Que faire à la place
Utilisez des voix avec les autorisations appropriées et signalez, si nécessaire, les contenus audio synthétiques ou guidés par un enregistrement de référence.
Étape suivante
Comprendre le modèle dans son contexte
Pour comprendre f5 tts, le plus simple est de comparer ses entrées, son fonctionnement et les résultats générés. Découvrez-le via l’interface proposée, puis déterminez si son approche fondée sur un enregistrement de référence convient à votre projet de narration ou de voix.
Écoutez ce que peut produire une synthèse vocale guidée par un enregistrement de référence
- Commencez par un enregistrement de référence clair
- Utilisez un texte court avec une ponctuation simple
- Vérifiez chaque résultat généré avant de le publier
Question fréquente
FAQ sur f5 tts
f5 tts est un modèle de synthèse vocale qui génère de l’audio parlé à partir d’un texte, en s’appuyant sur un enregistrement de référence pour guider la voix. Il est conçu pour une synthèse vocale fondée sur une référence, plutôt que pour le seul choix parmi une liste fixe de voix prédéfinies.
C’est à la fois un modèle vocal entraîné et un élément d’un processus de synthèse vocale. Le modèle traite le texte et l’audio de référence ensemble pour créer un nouvel extrait parlé aux caractéristiques acoustiques proches.
Non. f5 tts peut s’appuyer sur un enregistrement de référence pour guider le timbre, le rythme et l’interprétation, mais le résultat dépend de l’enregistrement, du texte et des conditions de génération. La ressemblance est un objectif de qualité, pas une garantie.
Le fonctionnement de base nécessite un texte à prononcer et un enregistrement de référence adapté. Un enregistrement clair d’une seule personne fournit généralement au modèle des informations plus utiles qu’un extrait bruité, tronqué, comportant des voix qui se chevauchent ou très court.
f5 tts peut être utile aux développeurs, aux créateurs, aux chercheurs et aux équipes qui explorent la narration expressive ou guidée par un enregistrement de référence. Il convient surtout lorsque l’adaptation à une voix de référence compte davantage que l’utilisation d’une voix prédéfinie.