Visão geral do modelo
O que é f5 tts? Um guia claro sobre o modelo de síntese de fala
O que é f5 tts? É um modelo de síntese de texto para fala que usa uma gravação de referência curta e um texto escrito para produzir uma fala com características vocais, ritmo e expressividade semelhantes. Este guia explica o modelo em termos práticos.
Fluxo de trabalho principal
Como o f5 tts funciona
O f5 tts combina uma voz de referência com o texto-alvo e, em seguida, gera uma fala que segue as características acústicas da referência, preservando as palavras solicitadas.
-
1
Forneça um áudio de referência
Escolha uma amostra de voz nítida, com conteúdo falado suficiente para que o modelo identifique o tom, o ritmo, a pronúncia e outras características acústicas.
-
2
Adicione o texto-alvo
Insira as palavras que você quer que sejam faladas. O texto fornece a mensagem, enquanto a gravação de referência fornece o exemplo vocal que orienta o resultado.
-
3
Gere a fala
O f5 tts alinha a referência e o texto e, em seguida, sintetiza um resultado de áudio desenvolvido para soar coerente, natural e relacionado à voz fornecida.
Caminhos relacionados
O que o f5 tts pode fazer
Estas páginas relacionadas analisam o modelo sob perspectivas práticas, incluindo seu comportamento vocal, acesso online e fluxo de clonagem.
- voz do f5 tts Veja como a voz de referência do modelo molda o tom, o ritmo e o caráter da fala gerada.
- f5-tts online Veja o que uma interface online muda em comparação com a execução do modelo em uma configuração local.
- clonagem de voz com f5 tts Entenda como a síntese baseada em referência se relaciona à clonagem de voz e em quais situações o uso cuidadoso é importante.
Da entrada à saída
f5 tts na prática
A transformação central é simples: uma gravação de voz de referência e um roteiro escrito se tornam uma nova fala. A qualidade depende da gravação, do texto e das configurações de geração.
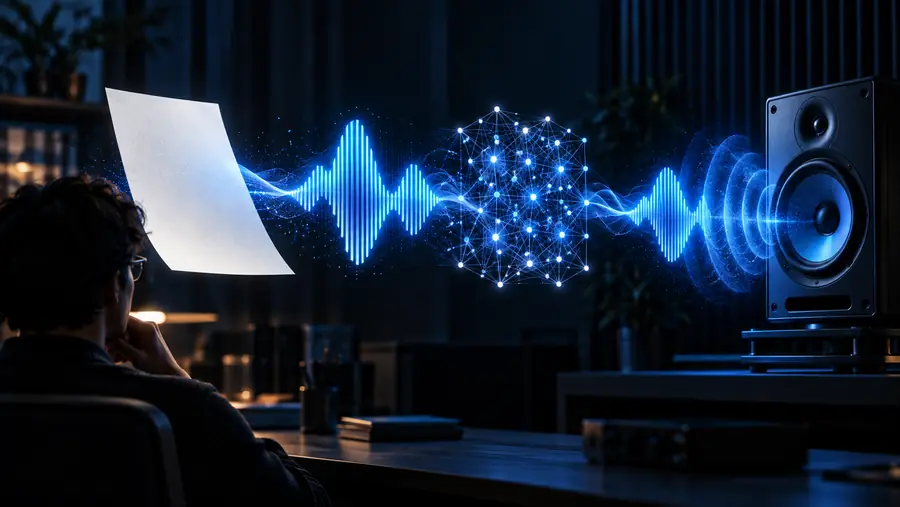
O resultado segue a referência, mas não é uma reprodução perfeita dela.
Referência e roteiroFala geradaUma comparação prática
Quem usa f5 tts
É melhor entender o f5 tts como um modelo de fala guiado por referência, e não como um substituto universal para todos os fluxos de trabalho com voz.
| Fluxo de trabalho do f5 tts | TTS convencional com vozes fixas | |
|---|---|---|
| Entrada de voz | Usa uma gravação curta de referência para orientar a voz gerada | Geralmente seleciona uma voz de uma biblioteca predefinida |
| Controle do texto | Gera fala a partir do roteiro fornecido | Gera fala a partir do roteiro fornecido |
| Variedade de vozes | Pode adaptar o resultado a diferentes vozes de referência | A variedade depende das vozes disponibilizadas pelo provedor |
| Características expressivas | Pode refletir aspectos do ritmo e da interpretação da referência | Muitas vezes segue os limites de estilo de uma voz fixa |
| Consistência | Pode variar conforme a qualidade da referência, o texto e as configurações | Frequentemente mais previsível dentro de uma voz predefinida |
| Usuários típicos | Criadores, pesquisadores, desenvolvedores e equipes que testam fluxos de trabalho de voz | Qualquer pessoa que precise de uma fala direta a partir de uma predefinição estável |
| Mais indicado para | Experimentos baseados em referências e narração expressiva | Narração rotineira com uma voz conhecida e repetível |
Ressalvas importantes
Limitações do f5 tts
Mesmo um modelo capaz precisa de entradas adequadas e uso responsável. Esses limites ajudam a definir expectativas realistas antes de gerar fala.
Não pode garantir uma cópia vocal exata
Uma gravação de referência orienta o resultado, mas a fala gerada pode diferir em timbre, pronúncia, emoção ou ritmo.
O que fazer em vez disso
Use uma referência limpa e relevante e compare várias saídas, em vez de esperar uma duplicata perfeita.
Não pode corrigir toda gravação de baixa qualidade
Ruído de fundo, sobreposição de vozes, clipping, amostras muito curtas ou fala pouco clara podem enfraquecer o sinal de referência.
O que fazer em vez disso
Comece com uma gravação clara contendo um único falante e o mínimo possível de ruído ambiente.
Não substitui a revisão editorial
A saída pode pronunciar incorretamente nomes, abreviações, palavras incomuns ou textos com pontuação ambígua.
O que fazer em vez disso
Ouça o resultado completo e revise o roteiro ou as seções sensíveis à pronúncia.
Não pode estabelecer autorização para uma voz
A capacidade técnica não prova que uma pessoa concordou com o uso de sua voz gravada.
O que fazer em vez disso
Use vozes com autorização apropriada e identifique o áudio sintético ou orientado por referência quando necessário.
Próximo passo
Coloque o modelo em contexto
O f5 tts é mais fácil de entender comparando suas entradas, seu fluxo de trabalho e os resultados gerados. Explore a experiência pela rota de produto disponível e, em seguida, avalie se sua abordagem baseada em referência é adequada para seu projeto de narração ou voz.
Veja como pode soar a fala orientada por referência
- Comece com uma gravação de referência nítida
- Use um roteiro curto com pontuação simples
- Revise cada resultado gerado antes de publicar
Pergunta frequente
Perguntas frequentes sobre o f5 tts
O f5 tts é um modelo de conversão de texto em fala que gera áudio falado a partir de texto escrito, usando uma gravação de referência para orientar a voz. Ele foi desenvolvido para síntese de fala baseada em referência, em vez de permitir a escolha apenas entre uma lista fixa de vozes predefinidas.
Ele é tanto um modelo de fala treinado quanto parte de um fluxo de trabalho de conversão de texto em fala. O modelo processa o texto junto com o áudio de referência para criar um novo trecho falado com características acústicas relacionadas.
Não. O f5 tts pode usar uma gravação de referência para orientar o caráter vocal, o ritmo e a forma de entrega, mas os resultados dependem da gravação, do roteiro e das condições de geração. A semelhança deve ser tratada como uma meta de qualidade do resultado, não como uma garantia.
O fluxo de trabalho básico precisa do texto-alvo e de uma gravação de referência adequada. Um áudio nítido de um único locutor geralmente fornece ao modelo informações mais úteis do que um material com ruído, cortes, sobreposição de vozes ou muito curto.
O f5 tts pode ser útil para desenvolvedores, criadores, pesquisadores e equipes que exploram narração expressiva ou orientada por referência. Ele é mais apropriado quando adaptar uma referência de voz é mais importante do que usar uma voz predefinida padrão.