Descripción general del modelo
¿Qué es f5 tts? Una guía clara sobre el modelo de voz
¿Qué es f5 tts? Es un modelo de texto a voz que utiliza una grabación de referencia breve y un texto escrito para producir un discurso con un carácter vocal, ritmo y expresividad similares. Esta guía explica el modelo en términos prácticos.
Flujo de trabajo principal
Cómo funciona f5 tts
f5 tts combina una voz de referencia con el texto de destino y, a continuación, genera un discurso que sigue las características acústicas de la referencia mientras conserva las palabras solicitadas.
-
1
Proporciona el audio de referencia
Elige una muestra de voz clara con suficiente contenido hablado para que el modelo identifique el tono, el ritmo, la pronunciación y otras características acústicas.
-
2
Añade el texto de destino
Introduce las palabras que quieres que se pronuncien. El texto proporciona el mensaje, mientras que la grabación de referencia proporciona el ejemplo vocal que guía el resultado.
-
3
Genera el discurso
f5 tts alinea la referencia y el texto y, a continuación, sintetiza un resultado de audio diseñado para sonar coherente, natural y relacionado con la voz proporcionada.
Secciones relacionadas
Qué puede hacer f5 tts
Estas páginas relacionadas examinan el modelo desde perspectivas prácticas, incluidos su comportamiento vocal, el acceso en línea y el flujo de trabajo de clonación.
- voz de f5 tts Descubre cómo la voz de referencia del modelo determina el tono, el ritmo y el carácter del discurso generado.
- f5-tts en línea Revisa qué cambia en una interfaz en línea en comparación con ejecutar el modelo mediante una configuración local.
- clonación de voz con f5 tts Comprende cómo la síntesis basada en referencias se relaciona con la clonación de voz y en qué aspectos es importante utilizarla con cuidado.
De la entrada a la salida
f5 tts en la práctica
La transformación central es sencilla: una referencia de voz y un guion escrito se convierten en un nuevo fragmento hablado. La calidad depende de la grabación, el texto y la configuración de generación.
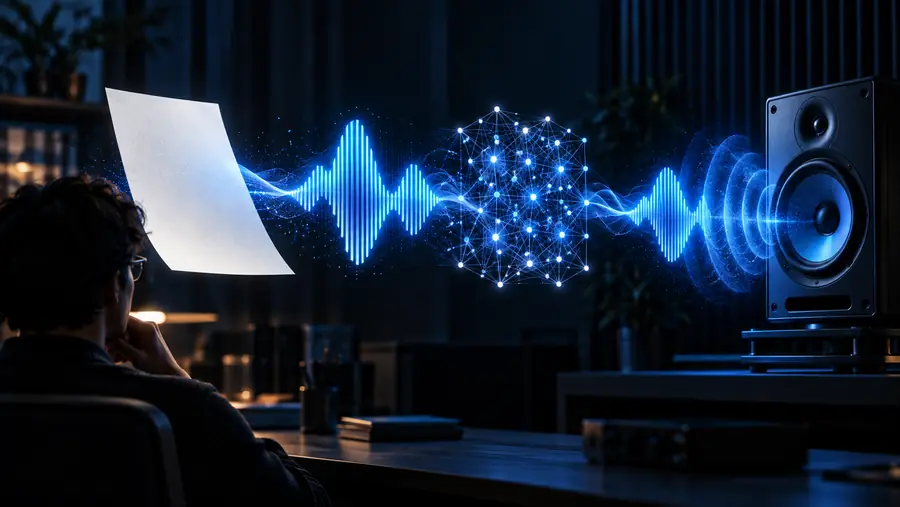
El resultado sigue la referencia, no es una grabación perfecta de ella.
Referencia y guionVoz generadaUna comparación práctica
Quién usa f5 tts
f5 tts se entiende mejor como un modelo de voz guiado por una referencia que como un reemplazo universal para todos los flujos de trabajo de voz.
| Flujo de trabajo de f5 tts | TTS convencional de voz fija | |
|---|---|---|
| Entrada de voz | Utiliza una grabación de referencia breve para guiar la voz generada | Normalmente selecciona una voz de una biblioteca predefinida |
| Control del texto | Genera voz a partir del guion proporcionado | Genera voz a partir del guion proporcionado |
| Variedad de voces | Puede adaptar el resultado para aproximarlo a distintas voces de referencia | La variedad depende de las voces incluidas por el proveedor |
| Indicaciones expresivas | Puede reflejar aspectos del ritmo y la forma de expresión de la referencia | A menudo sigue los límites de estilo de una voz fija |
| Consistencia | Puede variar según la calidad de la referencia, el texto y la configuración | A menudo es más predecible dentro de una voz preestablecida |
| Usuarios habituales | Creadores, investigadores, desarrolladores y equipos que prueban flujos de trabajo de voz | Cualquier persona que necesite una voz directa a partir de una preestablecida estable |
| Más adecuado para | Experimentos basados en referencias y narración expresiva | Narración rutinaria con una voz conocida y reproducible |
Advertencias importantes
Dónde f5 tts tiene limitaciones
Incluso un modelo capaz necesita entradas adecuadas y un uso responsable. Estos límites ayudan a establecer expectativas realistas antes de generar voz.
No puede garantizar una copia vocal exacta
Una grabación de referencia guía el resultado, pero la voz generada puede diferir en timbre, pronunciación, emoción o ritmo.
Qué hacer en su lugar
Usa una referencia limpia y relevante, y compara varios resultados en lugar de esperar un duplicado perfecto.
No puede corregir todas las grabaciones deficientes
El ruido de fondo, las voces superpuestas, la saturación, las muestras muy cortas o el habla poco clara pueden debilitar la señal de referencia.
Qué hacer en su lugar
Empieza con una grabación clara que contenga una sola persona y el mínimo ruido ambiental.
No puede sustituir la revisión editorial
El resultado puede pronunciar mal nombres, abreviaturas, palabras inusuales o textos con puntuación ambigua.
Qué hacer en su lugar
Escucha el resultado completo y revisa el guion o las secciones sensibles a la pronunciación.
No puede establecer el permiso para usar una voz
La capacidad técnica no demuestra que una persona haya dado su consentimiento para usar su voz grabada.
Qué hacer en su lugar
Usa voces con la autorización correspondiente e identifica el audio sintético o guiado por una referencia cuando sea necesario.
Siguiente paso
Pon el modelo en contexto
La forma más sencilla de entender f5 tts es comparar sus entradas, su flujo de trabajo y los resultados que genera. Explora cómo funciona a través de la opción disponible en el producto y después evalúa si su enfoque basado en referencias se ajusta a tu proyecto de narración o voz.
Escucha cómo puede sonar el habla guiada por una referencia
- Empieza con una grabación de referencia clara
- Usa un guion breve con puntuación sencilla
- Revisa cada resultado generado antes de publicarlo
Pregunta frecuente
Preguntas frecuentes sobre f5 tts
f5 tts es un modelo de texto a voz que genera audio hablado a partir de texto escrito y usa una grabación de referencia para guiar la voz. Está diseñado para la síntesis de voz basada en referencias, en lugar de limitarse a elegir entre una lista fija de voces predefinidas.
Es tanto un modelo de voz entrenado como parte de un flujo de trabajo de texto a voz. El modelo procesa el texto junto con el audio de referencia para crear un nuevo fragmento hablado con características acústicas relacionadas.
No. f5 tts puede usar una grabación de referencia para guiar el carácter vocal, el ritmo y la forma de hablar, pero los resultados dependen de la grabación, el guion y las condiciones de generación. La similitud debe considerarse un objetivo de calidad del resultado, no una garantía.
El flujo de trabajo básico necesita el texto que se va a pronunciar y una grabación de referencia adecuada. Un audio claro de un solo hablante suele aportar al modelo información más útil que un material ruidoso, recortado, con voces superpuestas o muy breve.
f5 tts puede ser útil para desarrolladores, creadores, investigadores y equipos que exploran la narración expresiva o guiada por referencias. Es especialmente adecuado cuando adaptar una voz de referencia importa más que usar una voz predefinida estándar.